De mais de 2 horas para 16 segundos: como reduzimos em 99,80% o tempo de um relatório no SQL Server
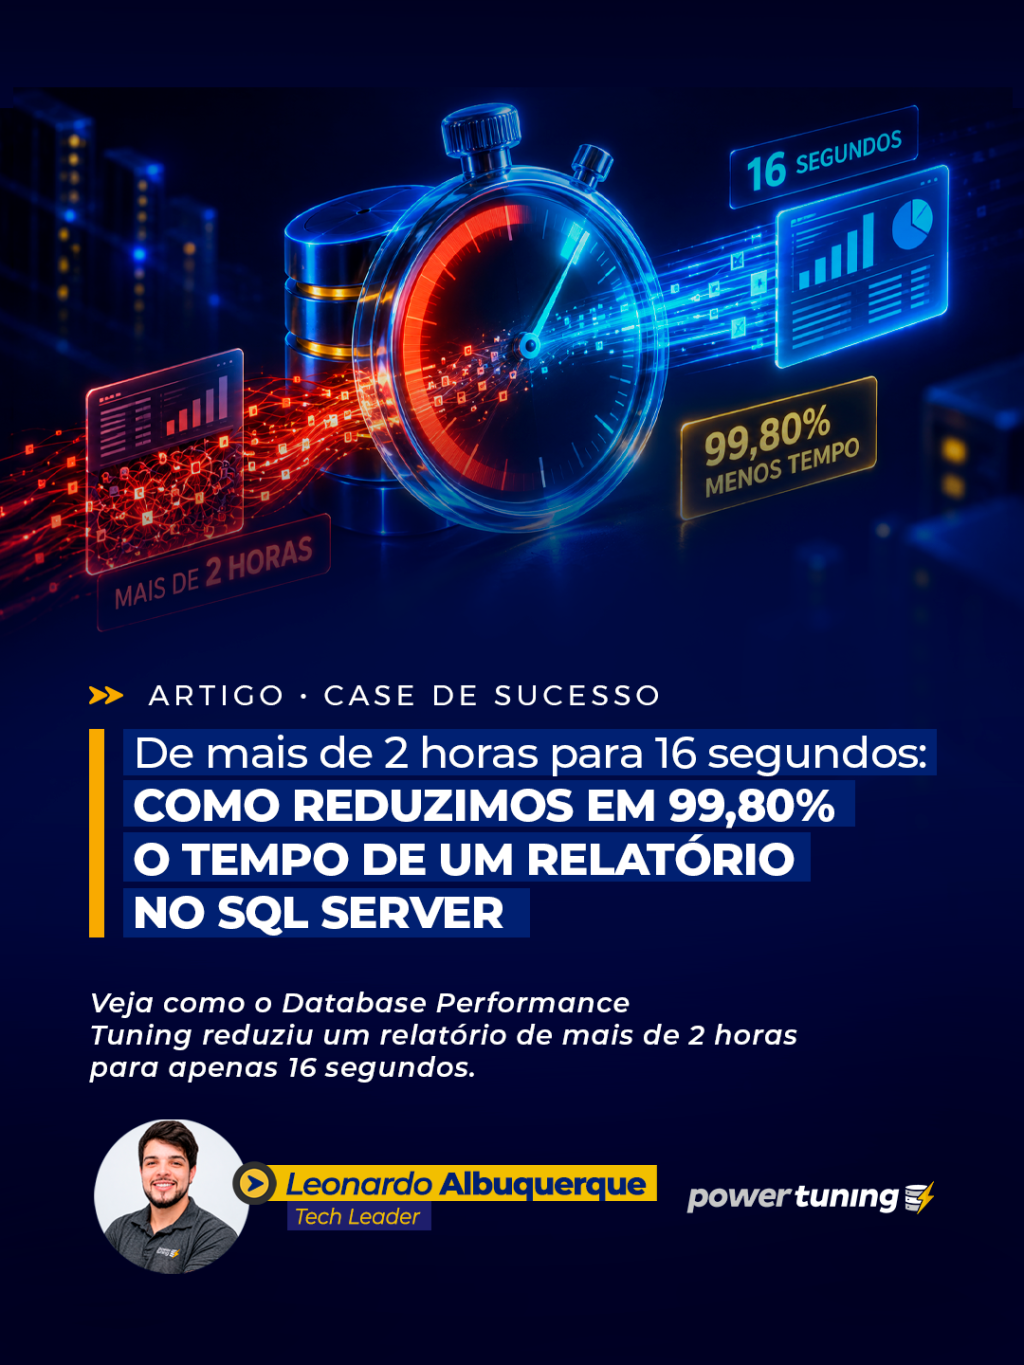
“Antes eu podia colocar o relatório para executar e ir tirar uma soneca. Agora não dá nem tempo de se levantar da cadeira.” 😂
Imagino que essa tenha sido a reação do cliente após ver o resultado de um trabalho de Tuning realizado em seu ambiente SQL Server:
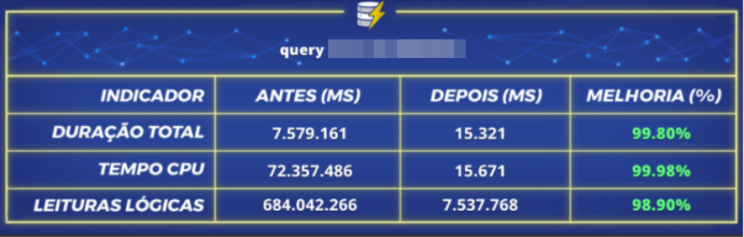
O relatório analisado levava mais de duas horas para ser concluído. Durante sua execução, consumia uma quantidade expressiva de CPU, realizava centenas de milhões de leituras lógicas e provocava pressão sobre recursos importantes do ambiente.
Após a otimização, o mesmo relatório passou a executar em aproximadamente 16 segundos.
Mais do que reduzir o tempo de uma consulta, o trabalho eliminou um importante ponto de contenção no ambiente.
O problema foi identificado pelo Power Alerts
O diagnóstico começou a partir das nossas rotinas de monitoramento do Power Alerts, que identificaram a consulta ofensora de CPU.
Com apenas 40 minutos de execução, a consulta já havia consumido mais de 34 milhões de milissegundos de CPU, atingindo o pico de 100% de uso da CPU do servidor.
Mas por que alertou só depois de 40 minutos em execução?
Pensando em diversos cenários para uma variedade de clientes, nossos alertas possuem thresholds configuráveis, por razões internas, esse cliente havia configurado o threshold para alertar apenas quando a CPU atingisse 98% de uso, e isso permanecesse por mais de 5 minutos seguidos, se não fosse isso, o alerta já teria sido disparado muito antes.
Um detalhe, é que este cliente está utilizando uma versão mais antiga dos alertas, e mesmo assim atendeu a necessidade para este ambiente, agora imagine com versão atual que tem mais de 98 mil linhas de código?!
A seguir um print de uma parte do e-mail enviado para o cliente, já era possível identificar pela coluna CPU Delta, o ofensor com maior consumo:
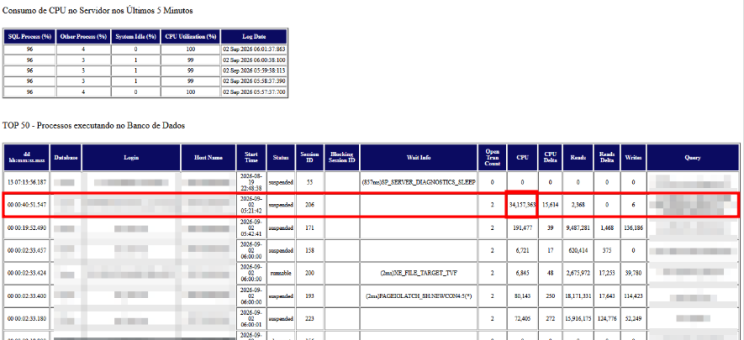
Esse ponto é essencial em trabalhos de performance: antes de alterar uma consulta, é necessário entender qual processo está realmente impactando o ambiente, com que frequência isso acontece e quais recursos estão sendo consumidos.
Nesse caso, o monitoramento permitiu encontrar uma consulta que, apesar de representar apenas um relatório para o usuário, tinha um impacto significativo no SQL Server.
O cenário encontrado
A consulta apresentava uma estrutura complexa, com:
-
Diversas CTEs;
-
Múltiplos JOINs;
-
Operações com OUTER APPLY;
-
Regras de negócio aplicadas durante a execução;
-
Processamento de grandes volumes de dados em tempo de execução.
O relatório também precisava consolidar informações de atendimento, contratos, clientes, movimentações financeiras etc.
O resultado era uma consulta funcional do ponto de vista do negócio, mas muito custosa do ponto de vista computacional.
Vejam os indicadores antes do tuning:
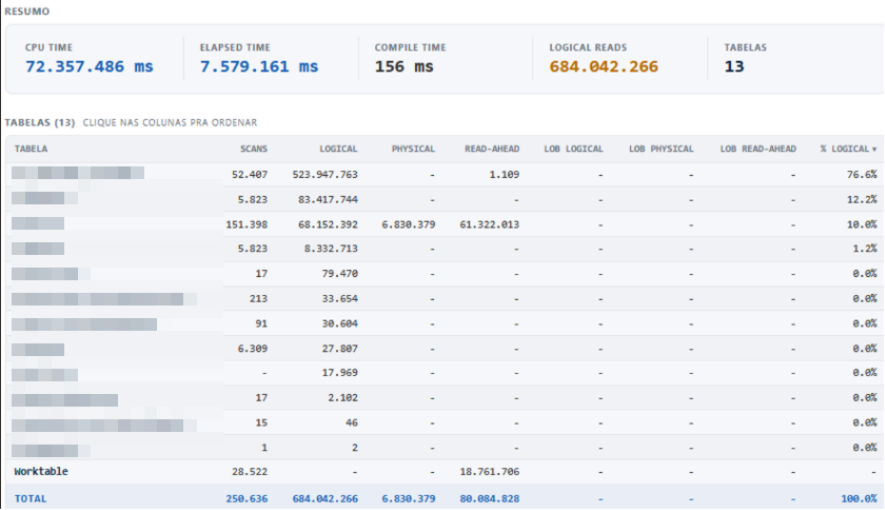
O SQL Server do cliente possuía 140 GB de memória configurada. Mesmo assim, durante a execução do relatório, foi possível observar queda no Page Life Expectancy, aumento no I/O (mais de 6 milhões de páginas foram buscadas no disco) e disputa pelo Buffer Pool.
É importante destacar que leituras lógicas não significam que todo o volume de dados permaneceu armazenado simultaneamente na memória. Elas representam o volume de páginas de 8 KB acessadas pela consulta ao longo da execução.
Ainda assim, acessar aproximadamente 5 TB em uma consulta executada em um ambiente com 140 GB de memória demonstra o tamanho da pressão provocada sobre o cache de dados, o armazenamento e os demais processos concorrentes.
O que estava acontecendo
As etapas da consulta eram processadas em tempo de execução. Dessa forma, grandes conjuntos de dados poderiam ser percorridos e reprocessados durante as operações de junção, filtragem e consolidação.
Esse tipo de comportamento pode provocar:
-
Aumento no consumo de CPU;
-
Maior quantidade de leituras lógicas;
-
Pressão sobre o Buffer Pool;
-
Queda no Page Life Expectancy;
-
Aumento de leituras físicas;
-
Disputa por I/O;
-
Eviction de páginas úteis;
-
Degradação do desempenho de processos concorrentes.
Uma consulta pesada não afeta apenas o usuário que está aguardando o relatório. Dependendo do ambiente, ela pode impactar aplicações, integrações, rotinas de ETL, processos financeiros e outras consultas executadas simultaneamente.
A estratégia aplicada
A estratégia adotada foi materializar algumas etapas intermediárias da consulta em tabelas temporárias.
Com isso, foi possível separar o processamento em fases mais controladas, reduzir o reprocessamento de grandes conjuntos de dados e melhorar o acesso às informações intermediárias.
Também foram utilizados índices nas tabelas temporárias para tornar as buscas e junções mais eficientes.
A abordagem permitiu:
-
Reduzir o processamento repetido de grandes volumes;
-
Melhorar o acesso aos resultados intermediários;
-
Aplicar índices de forma direcionada;
-
Diminuir o custo de JOINs;
-
Reduzir o impacto dos OUTER APPLYs;
-
Tornar o plano de execução mais eficiente;
-
Reduzir significativamente o volume de leituras lógicas;
-
Diminuir o consumo de CPU;
-
Liberar recursos para as demais cargas do ambiente.
O objetivo não foi simplesmente trocar CTEs por tabelas temporárias. O ponto principal foi entender como cada etapa era processada, quais resultados poderiam ser materializados e onde o acesso aos dados poderia ser otimizado.
Indicadores após o tuning:
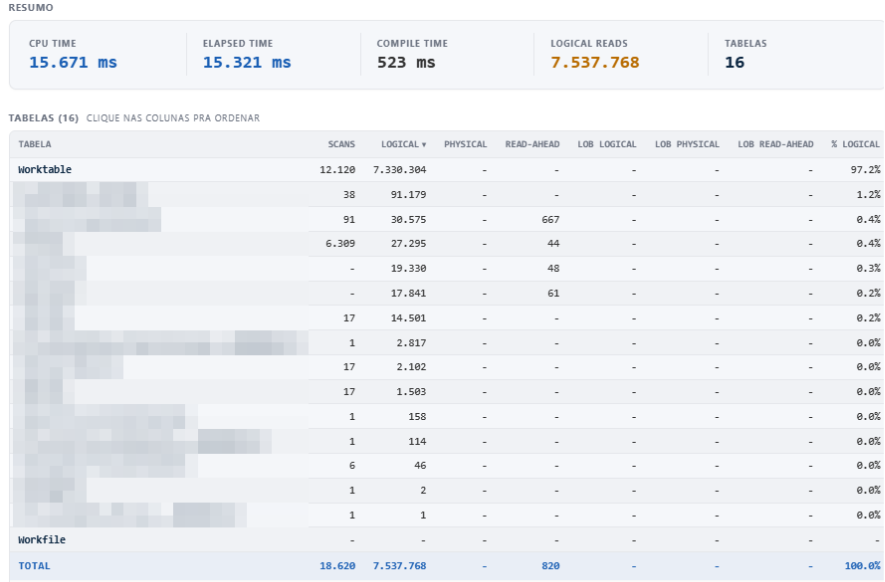
Na prática, o resultado foi:
-
De mais de 2 horas para aproximadamente 16 segundos;
-
Redução de 99,80% na duração total;
-
Redução de 99,98% no consumo de CPU;
-
Redução de 98,90% nas leituras lógicas;
-
De aproximadamente 5 TB percorridos para cerca de 60 GB;
-
Menor pressão sobre o Buffer Pool;
-
Menor impacto sobre o I/O;
-
Mais recursos disponíveis para as demais operações do ambiente.
Por que esse resultado é importante?
Uma redução de tempo dessa magnitude melhora diretamente a experiência do usuário, mas os ganhos vão muito além do relatório.
Ao reduzir o volume de dados processado e o consumo de CPU, o tuning também ajuda a:
-
Evitar contenção entre consultas;
-
Reduzir filas de I/O;
-
Preservar páginas importantes no Buffer Pool;
-
Diminuir o risco de lentidão em horários de maior concorrência;
-
Melhorar a previsibilidade do ambiente;
-
Reduzir a necessidade de executar novamente relatórios que falharam por timeout;
-
Aumentar a disponibilidade de recursos para aplicações críticas.
Esse caso reforça uma premissa importante de performance em bancos de dados:
> Não basta fazer a consulta funcionar. É necessário entender como ela consome os recursos do ambiente.
Uma consulta pode retornar o resultado esperado e, ainda assim, ser extremamente prejudicial ao SQL Server.
Monitoramento, diagnóstico e tuning precisam caminhar juntos
Sem monitoramento, a consulta poderia continuar sendo executada por mais de duas horas, consumindo mais de 20 horas de CPU acumulada e percorrendo aproximadamente 5 TB de dados.
Sem diagnóstico, seria difícil entender a origem do problema.
Sem tuning, o ambiente continuaria sujeito à pressão no Buffer Pool, ao aumento de I/O e à disputa de recursos com outras cargas importantes.
O Power Alerts foi fundamental para identificar o problema no ambiente real. A análise do plano de execução e o trabalho de tuning permitiram transformar os dados coletados em uma ação prática de otimização.
Esse é o valor de uma abordagem orientada por evidências: identificar, medir, otimizar e validar o resultado.
Conclusão
O caso mostra como uma consulta complexa pode impactar significativamente um ambiente SQL Server, mesmo quando atende corretamente à necessidade do negócio.
Por meio do monitoramento do Power Alerts e de uma estratégia direcionada de tuning, foi possível reduzir:
-
O tempo de execução de mais de 2 horas para 16 segundos;
-
O consumo de CPU em 99,98%;
-
As leituras lógicas em 98,90%;
-
O volume percorrido de aproximadamente 5 TB para cerca de 60 GB.
Performance não é apenas velocidade. É eficiência, estabilidade, previsibilidade e capacidade de o ambiente continuar atendendo às demais demandas.
Pensou em tuning, pensou em Power Tuning.
Artigo desenvolvido por: Leonardo Albuquerque (Tech Leader).